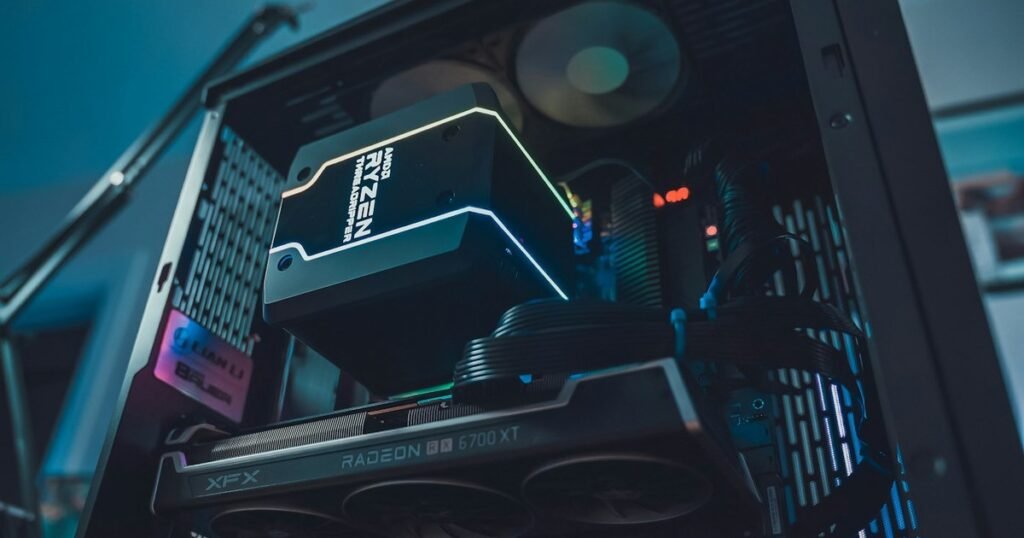
LLM local em PC mediano em 2026: o que é realista
LLM local 2026 no PC mediano: o que é realista em VRAM, privacidade e quando a nuvem ainda ganha.

Ki
Quando o assunto é LLM local 2026, o papo muda. LLM local não é independência digital romântica. É troca: privacidade e custo zero por token contra modelo menor, mais lento e sem as muletas da nuvem. Em PC mediano, a troca vale. O marketing de “GPT em casa”, não.
Shō
LLM local 2026: o que PC mediano realmente roda
Três faixas honestas em 2026:
- – 8 GB VRAM (RTX 3060 12 GB ainda é o doce; 8 GB aperta): 7B–8B quantizado em Q4/Q5 com folga. 14B no limite, contexto curto.
- – 12–16 GB VRAM: 14B confortável, 32B quantizado se você aceitar 15–25 tokens/s e menos contexto.
- – CPU + 32 GB RAM, sem GPU de verdade: 7B em llama.cpp. Útil. Lento. Melhor que nada pra texto.
Mac com 16–32 GB unificados continua o atalho silencioso: menos driver, menos calor, menos “CUDA out of memory” às 23h.
Esqueça 70B local no mediano. Cabe em discos. Não cabe em paciência.
Ten
O que de fato funciona no dia a dia
Tarefas que um 8B/14B local resolve bem:
- – Reescrita e tom de e-mail.
- – Resumo de texto que já está na sua máquina.
- – Extração de lista, regex mental, boilerplate.
- – Chat com seus markdowns via RAG simples.
Tarefas que ele finge resolver:
- – Pesquisa atual. Ele não sabe 2026. Inventa com confiança.
- – Código em stack rara. Alucina API.
- – Conselho médico/jurídico. Não.
Stack mínima: Ollama ou llama.cpp + um frontend (Open WebUI, AnythingLLM). Modelo com licença clara. Quantização Q4_K_M é o padrão de sanidade: qualidade aceitável, VRAM humana.
Contexto 8k–16k é o realista. 128k local em 8 GB é slide de keynote.
Jin
Como não transformar o PC em aquecedor inútil
- 1. Comece com um modelo, não cinco. Trocar GGUF é hobby. Usar é ofício.
- 2. Desligue GPU quando não estiver gerando. Ventoinha 24h não é “homelab”. É conta de luz.
- 3. Trate output como rascunho. LLM local erra mais e não tem o RLHF polido da nuvem.
- 4. Não exponha a API na internet “pra testar”. Isso não é artigo de pentest. É convite.
A pergunta útil não é “chego no ChatGPT?”. É “quais 30% do meu uso não precisam sair da máquina?”. Esses 30% justificam o setup. O resto, API paga com dado que você aceita enviar.
Privacidade não é absolutismo. É fronteira. Desenhe a fronteira. Depois escolha o modelo.
Fronteira de privacidade em LLM local 2026
Desenhe o que nunca sai da máquina: diário, contratos, código confidencial, saúde. O resto pode ir pra API se o ganho compensar. Privacidade não é absolutismo — é fronteira.
Stack mínima: Ollama/llama.cpp + UI + um modelo. Quantização Q4_K_M. Contexto 8k–16k realista. Não exponha API na internet “pra testar”.
A pergunta útil: quais 30% do uso não precisam sair do PC? Esses 30% justificam LLM local 2026. O resto, nuvem consciente.
Conexões úteis: se isso ressoou, vale cruzar com usar IA sem atrofiar e prompting que funciona. No acervo ao vivo também tem identificar burnout, dopamina sem mito e escolher fone bluetooth.
Pra aprofundar com fonte séria, veja Ollama — runtime popular pra LLM local: ollama.com.
Extra — prática de 7 dias
Dia 1: escreva em uma linha o que LLM local 2026 muda na sua rotina se você acertar. Dia 2: corte uma opção. Dia 3: teste a regra prática deste texto por 25 minutos. Dia 4: anote o que falhou sem drama. Dia 5: ajuste um único parâmetro. Dia 6: ensine a ideia pra alguém em 3 frases — se não consegue, você ainda não entendeu. Dia 7: decida manter ou dropar. Minimalismo nerd não é acumular método. É matar método que não paga.
Se você chegou até aqui e ainda está só “pesquisando”, isso também é dado: a pesquisa virou o hobby. Feche o ciclo com uma ação pequena hoje — não amanhã. Amanhã o feed inventa outro problema urgente.
Outro ponto: qualidade de atenção importa mais que qualidade de setup. Você pode acertar LLM local 2026 no papel e sabotar na execução com segunda tela, Discord aberto e culpa de backlog. Uma variável por vez. Uma sessão por vez. Um critério por vez.
Higiene de uso de IA
Toda resposta que for virar entrega pública passa por: (1) você consegue explicar o porquê; (2) uma fonte ou teste independente; (3) corte de enrolação. Se falhar em um, não publica.
Separe perfis/chats: trabalho, estudo, bobagem. Misturar contextos faz o modelo (e você) perder tom. Salve prompts bons. Delete threads que só geraram ansiedade de “produtividade”.
IA boa comprime tempo de rascunho. IA mal usada comprime tempo de pensamento. A diferença é protocolo, não modelo do mês.
No cotidiano, LLM local 2026 só vira ganho quando sai do artigo e entra na próxima hora do seu dia — não na próxima aba.
Erros comuns (e o antídoto)
Erro 1: acumular método sem testar. Antídoto: uma regra, sete dias.
Erro 2: otimizar setup e ignorar sono/atenção. Antídoto: métrica de sessão, não de equipamento.
Erro 3: tratar gosto como identidade moral. Antídoto: dropar sem manifesto.
Erro 4: pesquisar até a ação sumir. Antídoto: timer de decisão.
Erro 5: comparar sua bastidor com highlight alheio. Antídoto: caderno de evidência própria.
Se você reconheceu três erros, não precisa de mais conteúdo sobre LLM local 2026 agora — precisa de uma execução curta. Feche o leitor. Faça o passo mínimo. Volte amanhã se ainda fizer falta.
Perguntas frequentes
Consigo GPT-5 local?
Não no mediano. Consiga assistente 7B–14B honesto e privado.
Mac vale?
Memória unificada ajuda. Menos drama de driver.
RAG local resolve pesquisa?
Só no seu corpus. Atualidade de mundo ainda é nuvem/busca.
Gostou dessa leitura? Compartilha com quem precisa ver. Nerd Minimalista — conteúdo direto, sem enrolação.
 GuiaREA: como testar a IA que desmonta qualquer programaO REA liga Claude Code, Codex e Cursor a Ghidra, Hopper e IDA pra entender apps sem código-fonte. Passou de 128 mil estrelas no GitHub. Veja como funciona, os riscos legais e como testar.
 DicaO que não contar pro ChatGPT (e como desligar o treino com seus dados)Você conta pro chatbot coisa que não contaria pro chefe. Veja o que nunca colar numa IA, onde fica o botão que desliga o treino no ChatGPT, Gemini e Claude, e o que esse botão não resolve.
 GuiaCharacter.AI faliu: como salvar suas conversasA Character.AI entrou em recuperação judicial (Chapter 11) nos EUA e a Disney ofereceu US$ 20 milhões por uma licença da tecnologia, sem levar os chats. O app segue no ar por enquanto. Veja como baixar seus dados.
 DicaTrês regras pra usar ChatGPT no estudo sem atrofiar o cérebroChatGPT no estudo sem muleta: tente sozinho, peça contraste, ensine em voz alta. Roteiro de 60 minutos e quando pausar a IA.
Comentários (0)
Para comentar, entre ou crie sua conta.